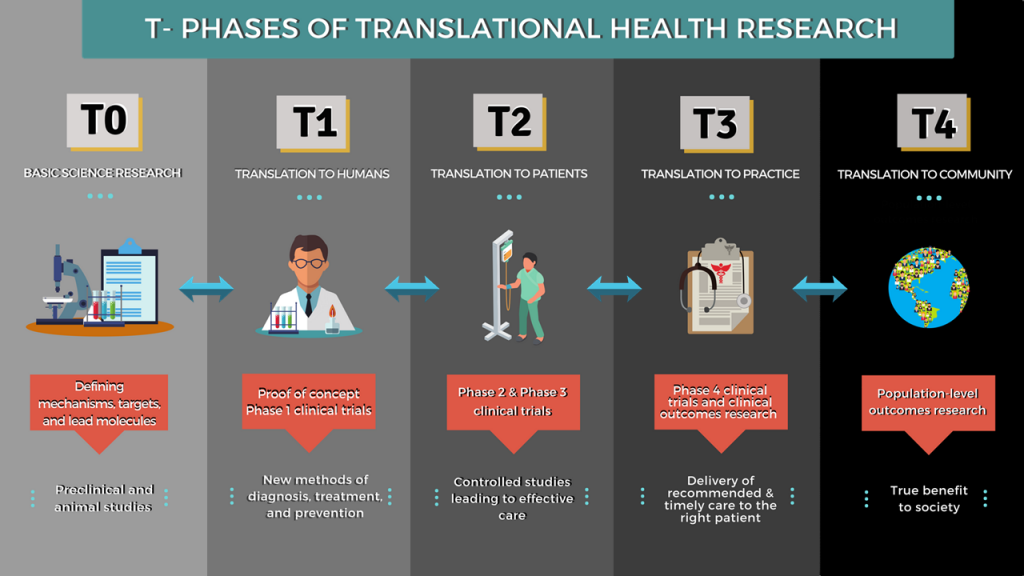
基礎研究で発見された疾患の仕組みや治療標的は、どのようにして患者の診断、治療薬の開発、個別化医療へとつながるのか。その過程を支えるのが、トランスレーショナルリサーチのデータ解析だ。細胞や動物モデルから得られた実験データと、患者のゲノム情報、検査値、治療経過などの臨床データを照合し、研究で観察された現象がヒトの疾患でも成立するのかを検証する。
2026年の研究開発では、統計解析やオミクス解析に加え、機械学習、電子カルテ、リアルワールドデータ(RWD)を活用した分析も重要な選択肢になっている。一方、データの量を増やすだけでは、臨床的に有用な結論は得られない。測定誤差、患者集団の違い、交絡、欠測、個人情報保護といった課題を管理し、再現可能な証拠を積み上げる必要がある。
📌 【この記事の重要ポイントまとめ】
- 基本的な考え方:基礎研究と臨床データを結び付け、病態の理解から治療標的やバイオマーカー候補の評価までを一貫して進める。
- 主要な解析手法:統計解析、ゲノム解析、多層オミクス統合、機械学習、生存時間解析などを研究目的に応じて組み合わせる。
- 臨床応用への条件:データ品質、独立した検証、臨床的有用性、研究データの再現性、個人情報保護を確保する。
【基礎から臨床へ】トランスレーショナルリサーチのデータ解析が果たす役割
トランスレーショナルリサーチとは、基礎研究で得られた知見を診断法や治療法などの開発につなげる研究活動を指す。英語では translational research と表記される。単に研究成果を臨床現場へ移すだけでなく、患者や医療現場で得られた知見を基礎研究へ戻し、仮説を修正する循環的な取り組みも含まれる。
米国国立衛生研究所(NIH)の国立先端トランスレーショナル科学センター(NCATS)は、研究の流れを基礎研究、前臨床研究、臨床研究、臨床実装、公衆衛生へと広がるスペクトラムとして説明している。この流れは一方向ではなく、各段階の成果がほかの段階にフィードバックされる構造だ。患者や市民の関与も、研究を臨床的な成果へ結び付ける重要な要素とされている。
この連続した研究過程で、データ解析は異なる種類の証拠をつなぐ役割を担う。例えば、基礎研究で特定の遺伝子が炎症反応に関係すると判明しても、その遺伝子の発現変化が患者の症状や治療反応に結び付くとは限らない。患者検体、臨床検査値、疾患の重症度、治療後の転帰を照合し、関連性の強さや再現性を確かめる必要がある。
ここで区別したいのは、統計的に関連していることと、治療に利用できることは同じではないという点だ。ある遺伝子の発現量が病状と相関していても、それが病気の原因なのか、病気によって変化した結果なのか、別の因子に影響されているのかは、相関だけでは判断できない。
そのため、トランスレーショナルリサーチのデータ解析では、次の問いを順番に検討する。
- 基礎研究で観察された現象は、ヒトの疾患でも確認できるか。
- 疾患との関連は、年齢、性別、併存疾患、治療歴などを考慮しても成立するか。
- 得られた知見は、別の患者集団や研究施設でも再現できるか。
- その結果は診断、治療選択、予後予測、安全性評価の改善につながるか。
これらの問いを明確にすることが、解析手法を選ぶ前の出発点になる。目的が曖昧なまま大量のデータを探索すると、見かけ上は有望な結果が得られても、臨床応用に必要な証拠が不足する可能性がある。
【解析手法を比較】統計解析・オミクス解析・機械学習はどう使い分ける?
トランスレーショナルリサーチの統計解析では、研究の目的、データの種類、評価するアウトカムに応じて手法を選択する。単一の解析手法ですべての課題を解決することは難しく、仮説の検証、候補の探索、予測モデルの開発を区別することが重要だ。
1.統計解析:差や関連性を定量的に評価する
統計解析は、研究対象の特徴を記述し、群間の差や変数間の関連性を推定するための基本的な手法だ。連続値の比較にはt検定や分散分析、複数の因子を調整した関連性の評価には線形回帰やロジスティック回帰、時間経過とイベントの関係には生存時間解析などを用いる。
患者の追跡データを繰り返し測定する研究では、混合効果モデルなどが候補になる。施設ごとの差や患者ごとのばらつきを考慮することで、単純な平均値の比較では捉えにくい変化を評価できる場合がある。
ただし、p値が小さいことだけを根拠に臨床的な重要性を判断してはいけない。効果量、信頼区間、臨床的に意味のある差、解析対象者数、欠測の影響などを合わせて評価する必要がある。
2.オミクス解析:病態に関係する分子の全体像を調べる
オミクス解析は、生体を構成する分子群を網羅的に測定し、疾患の特徴や治療反応に関係する分子を探索する手法群だ。代表的な解析対象には、DNA配列を調べるゲノム、RNA発現を調べるトランスクリプトーム、タンパク質を対象とするプロテオーム、代謝物を対象とするメタボロームがある。
例えば、ゲノムデータ解析で疾患との関連が示唆された遺伝子について、RNA発現やタンパク質量を調べれば、遺伝的な特徴が実際の生物学的機能とどのように関係しているかを検討できる。単一の測定結果に依存せず、異なる階層の証拠を組み合わせることが利点だ。
一方、測定対象が数千から数百万に及ぶ場合、多重検定による偽陽性の増加が問題になる。偽発見率(FDR)の制御、事前に定めた仮説の検証、独立した検体での再評価などを組み合わせる必要がある。
3.多層オミクス統合:異なる分子情報をつなぐ
多層オミクスのデータ統合では、ゲノム、トランスクリプトーム、プロテオーム、メタボロームなどの情報を組み合わせ、疾患に関係する分子ネットワークや患者集団の特徴を調べる。
ただし、各データは測定単位、分布、欠測の発生パターン、データの規模が異なる。2025年に『Briefings in Bioinformatics』で公表された多層オミクス統合手法のレビューでも、高次元性、データの異質性、欠測値が統合上の主要課題として整理されている。統合モデルを複雑にする前に、測定品質とデータ間の対応関係を確認することが欠かせない。
4.機械学習:複雑なパターンを探索し、予測に活用する
機械学習は、多数の特徴量から疾患の分類、治療反応の予測、患者集団の層別化などに役立つパターンを学習する。ランダムフォレスト、勾配ブースティング、正則化回帰、ニューラルネットワークなど、目的とデータ特性に応じた手法が利用される。
しかし、予測精度が高いモデルが、疾患の原因を説明できるとは限らない。施設固有の検査方法や患者選択の傾向を学習してしまうこともある。研究対象者が学習データと評価データの両方に入るデータ漏洩や、特徴量選択を検証前の全データで実施することにも注意したい。
手法選択の基本は、研究目的を先に定めることだ。機序の検証には統計モデルや実験による検証、候補分子の探索にはオミクス解析、個々の患者の予測には機械学習が有力な選択肢となる。ただし、それぞれの方法は相互排他的ではなく、同一の研究で組み合わせて利用できる。
【実践手順を整理】基礎研究と臨床データを統合する進め方
研究データの統合は、異なるファイルを一つのデータベースにまとめれば完了する作業ではない。研究目的、患者や検体の対応関係、測定条件、変数の定義をそろえ、解析結果がどの証拠に基づくのか追跡できる状態を整える必要がある。
実務では、次の段階に分けて進めると、解析上の問題を早い段階で発見しやすい。
| 段階 | 主な作業・データ | 確認すべきポイント |
|---|---|---|
| 研究課題の定義 | 疾患仮説、治療標的、評価項目、研究計画 | 臨床的な問いと主要評価項目が明確か |
| データ収集 | 実験データ、検体情報、ゲノム、電子カルテ、検査値 | 取得条件、対象集団、同意範囲が適切か |
| 品質管理 | 欠測、外れ値、単位、重複、測定バッチの確認 | データの正確性、完全性、一貫性を評価できるか |
| データ統合 | 共通ID、変数定義、時点、標準化されたデータ形式 | 検体と患者、測定時点の対応が正しいか |
| 探索・統計解析 | 回帰分析、群間比較、オミクス解析、機械学習 | 交絡、多重検定、過学習、欠測の影響を管理できるか |
| 独立検証 | 別の検体、施設、患者集団による再解析 | 結果が別のデータでも再現されるか |
| 臨床応用の評価 | 診断性能、治療反応、予後、安全性、臨床的有用性 | 実際の医療判断を改善する証拠があるか |
最初の関門は、研究データと臨床データの対応付けだ。実験で使用した検体と患者の臨床情報を結び付ける際には、検体採取日、治療開始日、疾患の進行段階、採取前の治療歴などを確認する。時間軸がずれていれば、分子の変化と治療反応の関係を誤って解釈するおそれがある。
次に、変数の定義を統一する。例えば、同じ検査項目でも、施設によって単位や基準範囲が異なることがある。病名の表記、検査結果の符号化、治療開始日の定義などが統一されていなければ、データをまとめた際に実際には存在しない差が生じかねない。
標準化された用語やデータ形式の利用も有効だ。米国の医療情報分野では、電子カルテ情報の交換にHL7 FHIR、観察研究データの共通化にOMOP共通データモデルなどが利用されている。これらはすべての研究に必須というわけではないが、複数施設のデータを統合する際の互換性を高める手段になる。
また、データ統合の前に品質評価を行うことが重要だ。欠測値を一律に補完したり、外れ値を機械的に削除したりすると、患者集団の特徴や重要な生物学的シグナルを失う可能性がある。欠測が生じた理由を調べ、補完や除外の基準を定めたうえで、異なる仮定を用いた感度分析を実施することが望ましい。
最後に、解析手順を記録する。元データの版、前処理、除外基準、使用ソフトウェア、パラメータ、解析コードを管理すれば、結果が変化した際に原因を追跡しやすくなる。データ統合は単なる技術的作業ではなく、研究結果の信頼性を左右する工程だ。
【バイオマーカー探索の核心】候補分子を臨床で使える証拠に変えるには
バイオマーカー探索は、トランスレーショナルリサーチの代表的な応用分野だ。バイオマーカーとは、生理的な状態、病的な過程、曝露、治療への反応などを示すために測定される特性を指す。分子情報だけでなく、組織学的、画像的、生理学的な指標も含まれる。
米国食品医薬品局(FDA)が示すバイオマーカーの分類には、疾患リスク、診断、予後、治療効果の予測、薬力学的反応、安全性などに関わるものがある。何を評価するバイオマーカーなのかによって、必要な証拠も異なる。
例えば、治療前に測定した遺伝子発現パターンから治療反応を予測したい場合、疾患の有無を見分けるだけの解析では不十分だ。特定の治療を受けた患者で反応が予測できること、別の患者集団でも性能が維持されること、実際の治療選択に役立つことを検討する必要がある。
候補を臨床応用へ進めるには、次の3つの評価を区別すると理解しやすい。
第一に、分析的妥当性だ。測定法が対象物質を正確かつ安定して測定できるかを確認する。測定感度、特異度、精度、再現性、検体の保存条件、採取から測定までの時間などが検討対象になる。測定方法自体が不安定であれば、臨床データとの関連性も信頼できない。
第二に、臨床的な関連性と有用性の評価だ。候補バイオマーカーが疾患や治療反応とどの程度関係しているかを調べ、交絡因子や既存の診断指標を考慮しても追加的な情報を提供するかを検証する。診断を目的とする場合は感度や特異度、予後予測では識別能や較正、治療選択では治療効果との関係など、用途に合った指標が必要になる。
第三に、用途に応じた証拠の確立だ。FDAのバイオマーカー適格性確認プログラムでは、特定の用途、すなわちContext of Use(COU)において、バイオマーカーをどのように解釈し、医薬品開発にどう活用できるかを評価する。バイオマーカーが特定の用途で適格と認められることと、その測定装置や検査法が別途承認・認証されることは同義ではない。
ここで見落としやすいのが、バイオマーカーと代替評価項目の違いだ。ある指標が治療によって変化しても、その変化が患者の症状改善や生存期間の延長を確実に示すとは限らない。分子の変化を臨床的な利益の代わりとして用いるには、その用途を裏付ける追加の証拠が必要になる。
バイオマーカー候補の評価では、発見に使ったデータと検証に使うデータを分けることも重要だ。同じデータで候補を選び、そのデータ上で性能を評価すると、偶然に適合した候補を過大評価する可能性がある。候補の選択後に独立した検体や別施設のデータで再検証することで、臨床応用に向けた信頼性を高められる。
【機械学習とリアルワールドデータ】臨床研究の分析をどう変えるか
臨床データ解析では、無作為化比較試験のデータに加え、電子カルテ、医療費請求データ、疾患登録、検査記録などのリアルワールドデータ(RWD)を利用する機会が広がっている。RWDは日常診療などから得られるデータを指し、その分析から得られる臨床的なエビデンスはリアルワールドエビデンス(RWE)と呼ばれる。
RWDの利点は、臨床試験では把握しにくい長期的な治療経過、実際の診療での薬剤使用、患者集団の多様性などを調べられることだ。一方、日常診療のデータは、研究目的で統一された条件のもとに収集されているとは限らない。治療選択の違い、記録の欠落、診断基準の変更、患者が医療機関を受診する頻度などが分析結果に影響する。
FDAは2024年7月、医薬品や生物学的製品の有効性・安全性に関する規制上の判断を支えるため、電子カルテと医療費請求データを評価する最終ガイダンスを公表した。そこでは、データの関連性と信頼性を検討し、研究目的に適したデータであるかを評価する考え方が示されている。
実務上は、データが大量に存在することと、研究に利用できる品質を備えていることを区別しなければならない。例えば、薬剤の処方記録があるからといって、患者が実際に薬を服用したことまで確定できるとは限らない。診療記録に転帰が記載されていない場合も、転帰が発生していないのか、単に記録がないのかを区別する必要がある。
機械学習を活用する際は、予測性能だけでなく、臨床現場での有用性を評価する。予測モデルでは、識別能、較正、臨床的な意思決定への寄与を別々に確認することが重要だ。例えば、患者を高リスク群と低リスク群に分けられても、予測確率が実際の発症率と大きくずれていれば、治療方針を決める用途には適さない場合がある。
臨床予測モデルの報告指針であるTRIPOD+AIは、回帰モデルと機械学習モデルの双方について、研究目的、方法、結果を透明性高く報告するための推奨事項を示している。学習データと評価データの対象者を重複させないこと、実際に利用する患者集団に近いデータで性能を評価することも重要な考え方だ。
臨床試験の統計解析では、解析計画を事前に定めることが基本となる。主要評価項目、解析対象集団、欠測データへの対応、多重性の調整、共変量の扱いなどをあらかじめ検討する。FDAは2023年5月に無作為化臨床試験の共変量調整に関する最終ガイダンスを公表しており、予後に関係するベースライン因子を適切に考慮することで、治療効果の推定精度を改善できる場合があると説明している。
ただし、RWDの解析結果を無作為化比較試験の結果と単純に同等視することはできない。研究デザイン、交絡の制御、データの欠落、対象集団の違いを考慮し、どのような判断を支える証拠なのかを明確にする必要がある。
【解析課題と信頼性】データ品質・再現性・個人情報保護をどう確保する?
トランスレーショナルリサーチの解析課題は、統計手法の選択だけではない。データの取得から保管、統合、分析、結果の共有に至るまで、各工程で品質と研究倫理を確保する必要がある。
データ品質の評価方法
品質評価では、正確性、完全性、一貫性、適時性、追跡可能性、研究目的への適合性を確認する。例えば、患者の年齢が不自然な値になっていないか、同一患者の記録が重複していないか、検査値の単位が混在していないか、測定時点が研究計画と整合しているかを点検する。
オミクス解析では、測定装置、試薬、実験日、施設などの違いによって生じるバッチ効果にも注意が必要だ。バッチ効果が疾患群と対照群の違いに重なっている場合、解析によって見つかった差が生物学的な違いなのか、測定条件の違いなのか判別しにくくなる。実験計画の段階で群を適切に配置し、品質管理用の試料を利用することが有効になる。
品質基準は、解析後に都合よく設定するのではなく、研究目的と測定方法に応じて事前に定めることが望ましい。除外したデータ、補完した値、品質基準から逸脱した測定については、理由と処理内容を記録する。
研究データの再現性と再利用
再現性を高めるには、解析コードを保存するだけでは足りない。元データのバージョン、データ処理の手順、使用したライブラリやソフトウェア、パラメータ、乱数シード、解析環境、結果を生成したコードを関連付けて管理する必要がある。
米国NIHのデータ管理・共有ポリシーは2023年1月25日に発効し、対象となるNIH資金による研究について、データ管理・共有計画の提出とその計画に沿った運用を求めている。また、NIHは、データを見つけやすく、アクセスでき、相互運用でき、再利用できる状態にするFAIR原則を推奨している。
FAIR原則は、研究データを無条件に公開することを意味しない。データの所在や意味を明確にし、適切な権限を持つ利用者が、標準的な手段でアクセスし、条件に従って再利用できるようにする考え方だ。患者のプライバシーや同意範囲に配慮したアクセス制御と両立させることができる。
医療データの個人情報保護
日本では、病歴、診療情報、健康診断の結果などは、個人情報保護法上の要配慮個人情報に該当し得る。個人情報保護委員会の医療・介護関係事業者向けガイダンスでは、こうした情報の取得や個人データの第三者提供について、原則として本人の同意が必要であることなどが示されている。適用される法令上の例外や研究に関する指針も含め、具体的な取り扱いを確認することが必要だ。
研究機関が実施すべき対策には、利用目的とアクセス権限の明確化、データの仮名化・匿名化の適切な検討、暗号化、アクセスログの管理、安全な保管、外部提供時の審査などがある。氏名を削除しただけで、個人が再識別されるリスクがなくなるとは限らない。ゲノム情報や希少疾患の情報などは、ほかの情報との組み合わせによって個人が推定される可能性にも注意したい。
研究データを外部の解析サービスや生成AIに入力する場合も、研究計画、利用規約、機関の情報セキュリティ規程、患者の同意内容との整合性を確認する必要がある。解析の利便性だけを優先せず、利用可能なデータの範囲と保護措置を事前に定めることが欠かせない。
トランスレーショナルリサーチで陥りやすい失敗
- 探索解析で得られた相関を、疾患の原因や治療効果の証明と解釈する。
- 独立した検証を行わず、同じデータで候補選択と性能評価を済ませる。
- 欠測値や測定バッチの影響を十分に確認せず、統合解析を進める。
- 機械学習モデルの精度だけを示し、較正や臨床的有用性を評価しない。
- データ共有を優先するあまり、同意範囲、利用目的、アクセス権限の管理を後回しにする。
これらの問題は、研究の最終段階で修正しようとすると、追加の検体採取や再解析が必要になることもある。研究計画の段階から品質管理、統計解析、データ管理、情報保護を一体的に設計することが、無駄な手戻りを抑え、研究成果の信頼性を高める近道だ。
【トランスレーショナルリサーチのデータ解析】に関するよくある質問(FAQ)
Q1:トランスレーショナルリサーチのデータ解析とは何ですか? A1:基礎研究で得られた生物学的な知見と、患者の臨床情報を統計解析やオミクス解析などで結び付け、疾患の仕組み、治療標的、バイオマーカー候補を評価する取り組みです。研究成果がヒトの疾患でも成立するかを検証し、診断法や治療法の開発につなげます。
Q2:統計解析とオミクス解析はどう違いますか? A2:統計解析は、データの特徴、群間差、関連性、治療効果などを定量的に評価する方法の総称です。オミクス解析は、ゲノムやRNA、タンパク質、代謝物などを網羅的に測定し、疾患に関係する分子や経路を探索する手法群です。オミクス解析で得た候補を統計解析で評価し、独立したデータで検証するなど、両者を組み合わせて利用します。
Q3:バイオマーカー候補が見つかれば、すぐに臨床応用できますか? A3:すぐに応用できるとは限りません。測定法の精度や再現性、疾患や治療反応との関連性、別の患者集団での検証、実際の診療における有用性などを評価する必要があります。バイオマーカーの用途によって必要な証拠は異なり、探索段階の有望な候補と、臨床で利用できる指標は区別しなければなりません。
Q4:リアルワールドデータは臨床試験の代わりになりますか? A4:研究目的やデータの品質によっては、医薬品の有効性・安全性評価を補完する証拠として利用できます。ただし、日常診療のデータには交絡、記録の欠落、治療選択の偏りなどが含まれる可能性があります。研究デザインとデータの信頼性を評価し、どのような判断を支える証拠になるのかを明確にすることが重要です。
Q5:研究データの再現性を高めるには何が必要ですか? A5:データの取得条件、前処理、除外基準、解析コード、ソフトウェアのバージョン、パラメータなどを記録し、第三者が解析手順を追跡できるようにします。さらに、候補の探索に使ったデータとは独立した検体や患者集団で検証することが重要です。患者情報を扱う場合は、同意範囲やアクセス権限を管理したうえで、適切なデータ共有の仕組みを整えます。
まとめ:【プロの結論】臨床応用を左右するのは解析手法より証拠の積み上げ方
トランスレーショナルリサーチのデータ解析は、基礎研究と臨床研究の間にある隔たりを埋めるための実践的なプロセスだ。統計解析による仮説検証、ゲノム解析や多層オミクスによる候補探索、機械学習による予測、リアルワールドデータによる実臨床での評価を組み合わせることで、研究成果を臨床応用へ近づけられる。
ただし、複雑な解析手法や大量のデータを使えば、自動的に信頼性の高い結果が得られるわけではない。データ品質が十分か、研究仮説に合った解析か、交絡や多重検定を管理できているか、独立したデータでも結果が再現されるかを一つずつ確認する必要がある。
研究プロジェクトを評価する際は、次の基準を押さえたい。
- 研究目的:何を明らかにし、どの臨床判断を改善するのかが明確である。
- データ品質:検体、測定値、臨床情報の対応関係と取得条件を追跡できる。
- 解析の妥当性:研究目的に適した手法を選び、欠測、交絡、多重検定、過学習を考慮している。
- 独立検証:探索結果を別の検体、施設、患者集団などで評価している。
- 臨床的有用性:統計的な関連だけでなく、診断、治療選択、安全性、予後などに対する実際の価値を検討している。
- データガバナンス:研究データの再現性を確保し、個人情報保護と適切なデータ共有を両立している。
2026年の研究開発で求められるのは、最新の解析技術を導入すること自体ではなく、その技術から得られた結論をどこまで信頼でき、どの範囲で臨床判断に利用できるのかを説明できることだ。基礎研究の発見を患者に届く成果へ変えるには、データの収集から独立検証、臨床的有用性の評価までを一貫して設計することが欠かせない。 (出典: translational research data analysis(Yahoo!ニュース))
